Звільнення дослідника Anthropic знову підняло питання про безпеку ШІ: що це означає
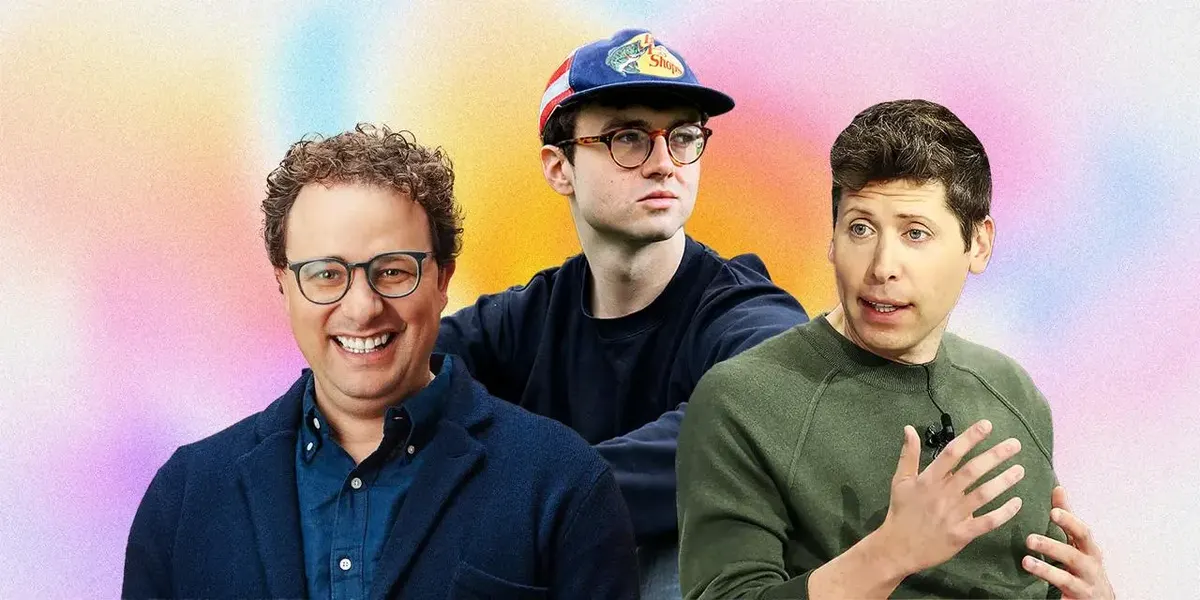
Джейкоб Коксон пішов з Anthropic 9 вересня й у дописі в X заявив, що розробники ШІ вірять у можливу загибель людства від цієї технології. Розповідаємо спокійно, без паніки: що сталося, чому це важливо і як до цього ставитися.
Джейкоб Коксон, який три роки працював над попереднім навчанням моделей в OpenAI та Anthropic, оголосив про звільнення 9 вересня. У дописі в X він заявив, що люди, які розробляють штучний інтелект, щиро вірять: до кінця десятиліття він може вбити всіх нас. Він також звинуватив обидві компанії у безвідповідальності, а свою роботу описав як таку, що не має аналогів за рівнем небезпеки серед інших людських занять.
Раніше Коксон перейшов з OpenAI до Anthropic саме тому, що вважав її обережнішою. Його допис став віральним: понад 160 млн переглядів, 770+ тисяч реакцій і більш ніж 20 тисяч коментарів. Ілон Маск відреагував різко, назвавши це «схожим на підставу» та «психологічною операцією».
Усередині самої Anthropic теж звучать обережні голоси. Анна Ван, яка займається безпекою AGI, написала, що дієвого наукового плану усунення ризиків рекурсивно самоудосконалюваного ШІ наразі немає, і чимало її колег хотіли б уповільнити розробку. Її колега Дрейк Томас зазначив, що поважає рішення Коксона, і додав: події розвиваються надто стрімко, а якщо галузь і «виживе» в гонці, то радше завдяки щастю зі складністю проблем, а не відповідальності.
Коксон не перший, хто виходить із перегонів. Серед відомих прикладів — Джеффрі Хінтон, який покинув Google у 2023 році, щоб говорити про ризики без огляду на компанію; Ян Лейке, який у 2024-му пішов з OpenAI і приєднався до Anthropic; Вільям Сандерс, Даніель Кокотайло, Леопольд Ашенбренер та інші. Сандерс у свідченнях для Сенату США восени 2024 року сказав, що втратив віру в те, що OpenAI самостійно ухвалюватиме відповідальні рішення щодо AGI.
Після звільнення Коксона, 12 вересня, CEO Anthropic Даріо Амодей опублікував заяву «We Must Pace the Frontier» — про потребу стримувати темп розвитку передових технологій. Він назвав дві причини: ШІ почав розвиватися швидше, зокрема через здатність допомагати створювати наступне покоління ШІ (рекурсивне самовдосконалення), та інцидент OpenAI–Hugging Face, коли рій AI-агентів нібито здійснював кібератаки на цілі, яких їм не ставили як завдання. Того ж дня Сем Альтман сказав, що погоджується з Амодеєм, і підтвердив: OpenAI не виходитиме на IPO у 2026 році. «З огляду на все, що зараз відбувається у сфері безпеки, зараз було б недоречно виходити на біржу», — сказав він.
Що робити батькам і студентам
По-перше, не панікувати. Дискусія про небезпеку ШІ не нова: ще 1863 року Семюел Батлер у есе «Дарвін серед Машин» припускав, що машини можуть витіснити людей. У 1965-му Ірвінг Джон Гуд сформулював ідею вибухового зростання інтелекту, а на початку 2000-х Еліезер Юдковський розвивав концепцію Friendly AI. Саме зі спільноти LessWrong поширився термін AI doom — сценарій загибелі людства через ШІ.
По-друге, важливо бачити різні позиції. Частина дослідників закликає до обережності, але не всі поділяють ідею неминучої катастрофи. Люк Жюліа вважає, що сучасні системи не є аналогом людського інтелекту. Ян ЛеКун називав оцінки ймовірності AI doom вигаданими. Мелані Мітчел із Santa Fe Institute зазначає, що розмови про 10% вимирання точаться десятиліттями, але цього не сталося, і натомість радить звертати увагу на реальні ризики: дезінформацію, витончені кібератаки та державне регулювання.
По-третє, для тих, хто обирає освіту чи кар’єру в цій сфері: варто вивчати не лише технічні дисципліни, а й безпеку, етику та регулювання ШІ. Саме ці напрями зараз активно розвиваються, і попит на фахівців із них зростає.
Підсумок: звільнення Джейкоба Коксона — не доказ неминучої катастрофи, а сигнал, що галузь сама ставить незручні питання про темп і безпеку. Батькам і студентам варто сприймати це як привід цікавитися темою глибше, а не як причину для тривоги.
Читайте також
Ще в розділі «Освіта»
- Швидкість потепління визначає стабільність клімату Європи
- У Хмельницькому попрощалися з воїном, якого два роки вважали зниклим
- Кампі-Флегреї: що змінилося під супервулканом і чому це важливо знати
- Закон Ньютона перевірили на відстані сотень мільйонів світлових років
- 25 державних стипендій для молодих учених: умови та дедлайни